Up to 3,2 есе жылдамдетілген есептеу LFM2.5-DSpark негізіндегі модельдерде
Кіріспе
Жасанды интеллект саласындағы үлкен тілдік модельдерді қолдану кеңінен тараған сайын, олардың жылдамдығы мен тиімділігі маңызды факторға айналды. Тілдік модельдерге қойылатын талаптардың өсуі өңдеу жылдамдығын арттыруды талап етеді. LFM2.5-DSpark технологиясы осы мәселені шешуге бағытталған жаңа тәсілдердің бірі ретінде ұсынылатынын және өңдеу жылдамдығын үш есе арттыруға мүмкіндік беретіні маңызды жаңалық.
Негізгі түсіндірме
LFM2.5-DSpark — LFM2.5 модельдерінің отбасы үшін жасалған шешім, артық жады шығынын азайтпастан жылдамдықты арттыруға арналған спекулятивті декодтау жолын қолданады. Бұл әдіс екі кезеңнен тұрады: жеңіл модель бастапқы ықтимал таңбаларды жылдам тізбектейді, кейін негізгі модель оларды бір өтуде растайды. Осы тәсіл дәстүрлі декодтау фазасындағы жадқа байланысты бөгеттерді жеңілдетеді. Нәтижесінде, GPU мен құрылғының өзінде есептеу жылдамдығы тиісінше 3,18 және 2,87 есе көбейеді.
DSpark спекулятивті декодтаудың үш негізгі компонентін біріктіреді:
- Негізгі контекст ерекшеліктерімен үйлесімді DFlash-стиліндегі параллель өңдеу жүйесі, барлық жобалық таңбаларды бір өтуде өндіріп шығарады.
- Кездесетін таңбалардың арасындағы тәуелділікті жоғары деңгейде қарастыратын жеңіл марковшақ басы, қабылдау ықтималдығын арттырады.
- Әр таңбаның сенімділік деңгейін анықтап, төмен сенімді қоспаларды жоятын сенімділікке негізделген тексеру механизмі.
Контекст және мысалдар
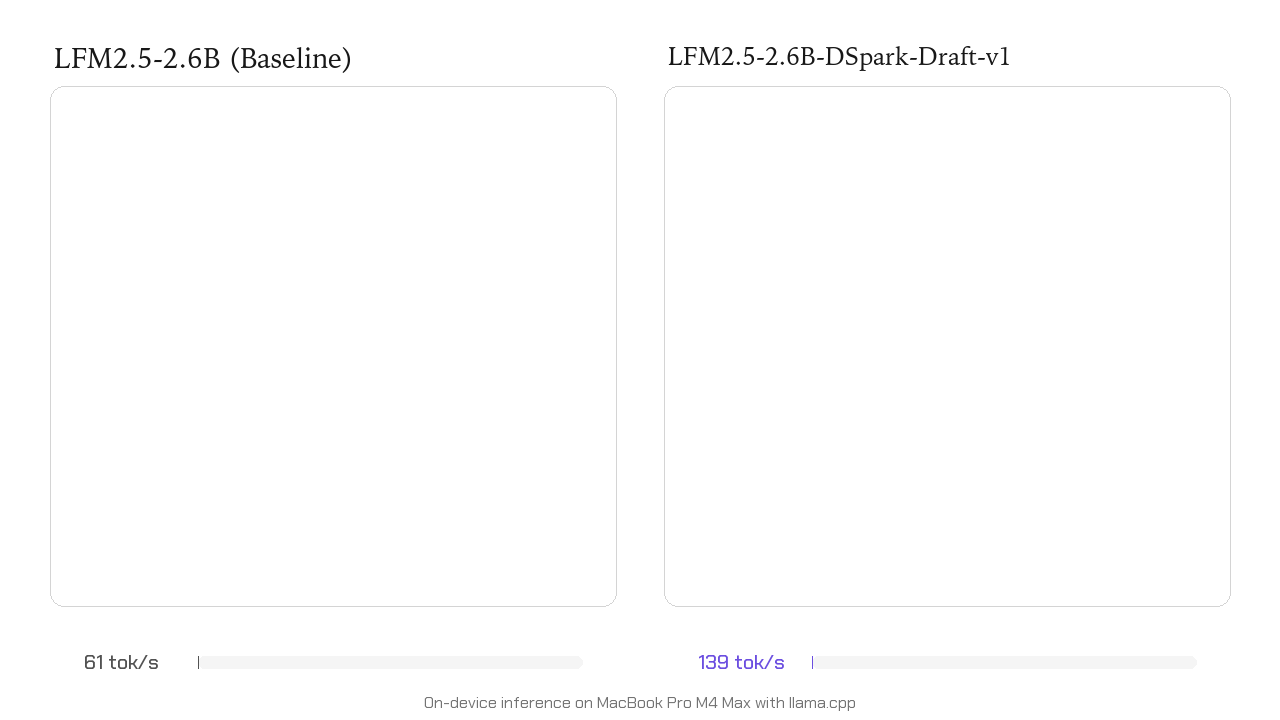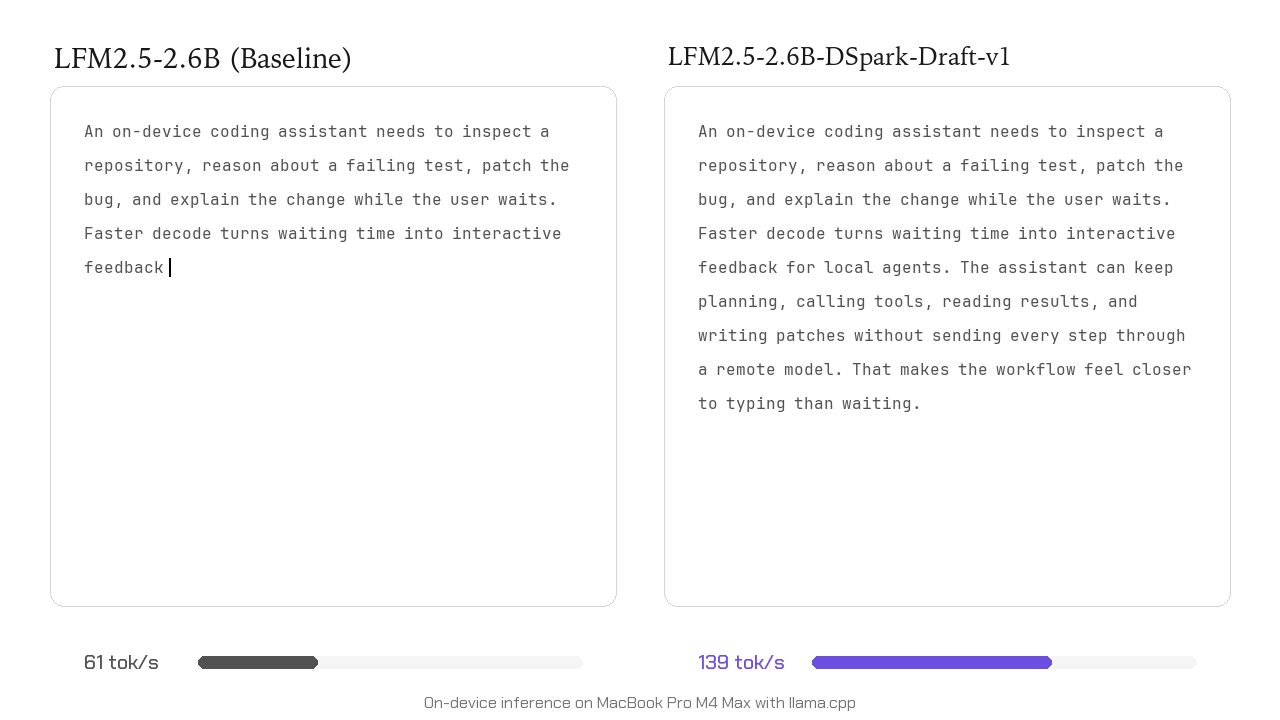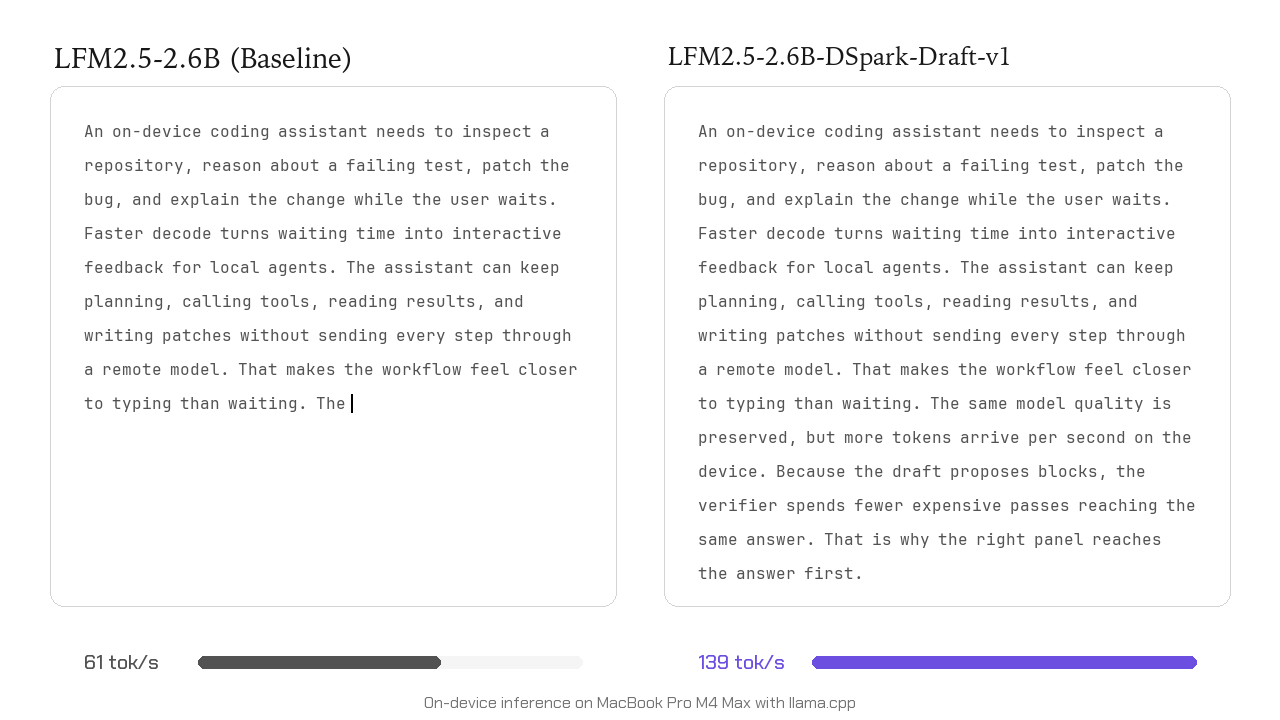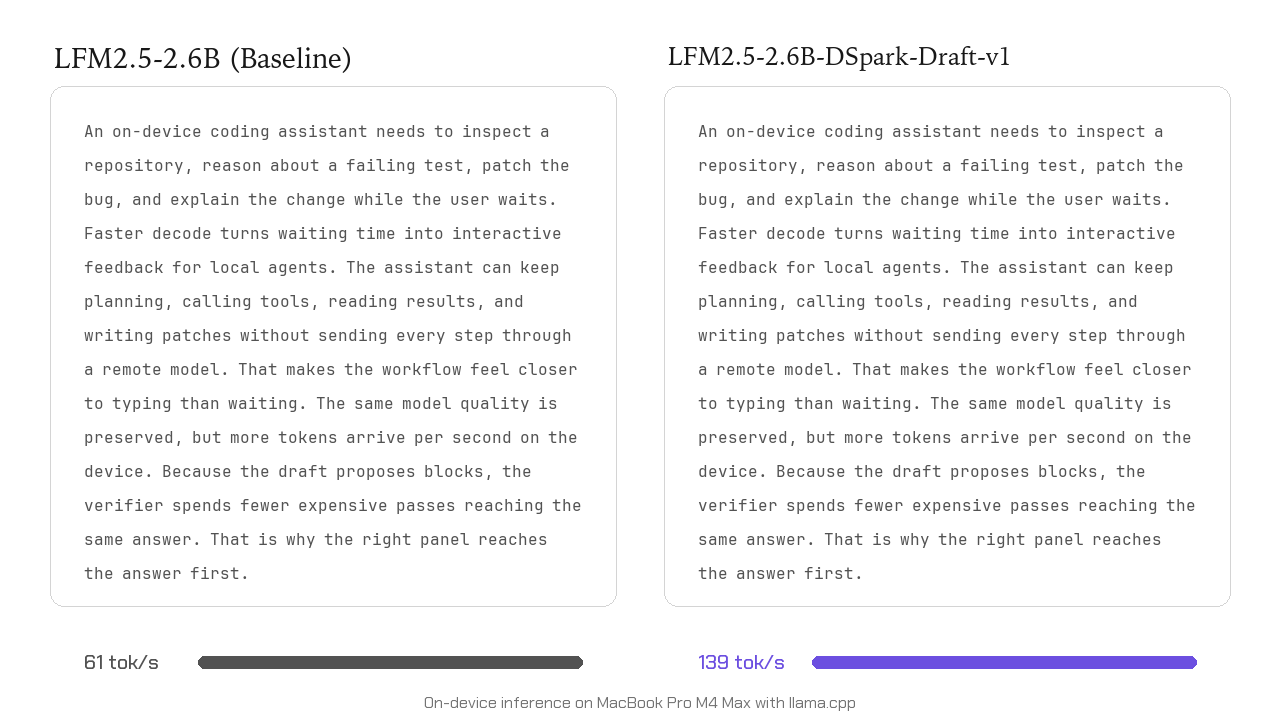
LFM2.5-DSpark моделінің негізгі артықшылығы — түрлі құрылғыларда жылдамдықты арттыру. Мысалы, Apple M4 Max процессорында жаңа технологиямен модельдер 2,2-ден 2,9 есеге дейін жылдам жұмыс істейді. NVIDIA H100 графикалық процессорында бұл көрсеткіш 2,5-тен 3,2 есеге дейін артады. Сонымен қатар, LFM2.5-2.6B модельдері функцияларды шақырудағы кідірісті 57% азайтады, бұл интерактивті агенттер үшін маңызды.
Қазіргі кезде көптеген тілдік модельдер жылдамдық пен сапа арасында компромисті қалыптастыруға тырысады. Алайда DSpark әдісі негіздік модельдің сапасын өзгеріссіз сақтай отырып, жылдамдықты жақсартуға бағытталған. Мысал ретінде нақты есептер жиынтығындағы тестілерде модельдер орташа есеппен 2,3-2,7 есе тиімдірек жылдамдық көрсетеді.
Практикалық маңызы
Қолданушылар LFM2.5-DSpark модельдерін llama.cpp және SGLang платформаларында пайдалана алады. Олар ашық дереккөз ретінде қолжетімді және әртүрлі аппараттық жабдықтарда оңтайлы жұмыс істеуге бейімделген. Бұл технология мобильді құрылғылар мен жеке компьютерлер үшін жасанды интеллект қызметтерін кең көлемде жетілдіруге мүмкіндік береді.
Модельдердің шағын көлемі (~300 миллион параметр) арқасында олар ресурстарды үнемдеп, кішкене жад пен есептеу қуаты бар құрылғыларда қосымша мүмкіндіктер береді. Бұл жасанды интеллектті көпқұралды сценарийлерде және функцияларды нақты уақытта шақыру кезінде кідірістерді айтарлықтай төмендетеді.
Қорытынды
LFM2.5-DSpark технологиясы үлкен тілдік модельдердің есептеу жылдамдығын арттыруда маңызды қадамды білдіреді. Оның спекулятивті декодтау тәсілі негіздік модельдің сапасын сақтай отырып, өңдеу уақытын азайтады. Бұл жасанды интеллекттің қолданылуын кеңейтіп, өндірістік және зерттеу мақсатындағы қосымшаларда өнімділікті жоғарылатады.
Дереккөз: Hugging Face Blog