Сөздік қорын мамандандыру арқылы SLM модельдерінің есептеу құнын 77% дейін төмендету
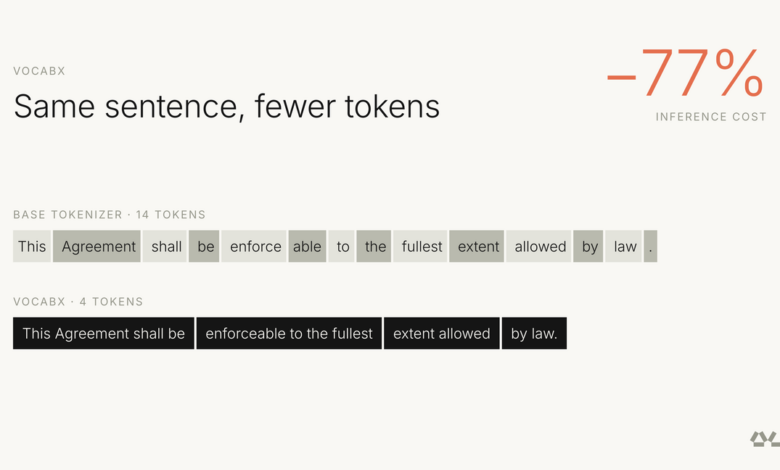
Жасанды интеллект саласындағы тілдік үлкен модельдер (SLM) мәтінді таңбаларға бөлетін арнайы сөздік қорға сүйенеді. Бұл сөздік қоры модельдің жылдамдығы мен тиімділігін айқындайтын маңызды ресурс саналады. Көпсалалы және көптілді жалпы модельдер үлкен және әртүрлі мәтінге бейімделген, сондықтан олардың сөздік қорлары көлемді әрі кең ауқымды болады. Дегенмен, нақты бір салаға немесе тапсырмаға мамандандырылған кезде бұл бостандық қате тұжырымдарға әкеліп, өнімділік шығындарына әсер етуі мүмкін. Осы мақалада тілдік модельдерінің сөздік қорын мамандандырған жағдайда, оның қандай әдістер арқылы есептеу шығындарын айтарлықтай азайтуға мүмкіндік беретіні туралы талқыланады.
Кіріспе
Тілдік модельдерді қолданғанда олар мәтінді таңбаларға бөлу механизмін пайдаланады. Бүл механизмнің сипаты – сөздік қордың құрылымы, яғни модельдің мәтінді қанша кішкентай бірлікке бөліп, олардың комбинациясынан тұрады. Жалпы қолдану үшін әзірленген модельдерге тән үлкен әрі қолданысқа кең сөздік қор кейбір нақты тапсырмаларда тиімсіздікке әкеледі. Сондықтан модельдің сөздік қорын нақты бір доменге бейімдеу арқылы есептеу ресурстарын үнемдеудің нәтижелерін қарастыру маңызды. Толыққанды үлгілері көрсеткендей, мұндай оңтайландыру нақты өндірістік жүйелерде 77% дейін шығынды қысқартуға мүмкіндік береді.
Негізгі түсіндірме
Көптеген тілдік модельдерінің токенизациясы – мәтінді бірнеше токенге (таңбаға) бөлу процесі модельдің жұмысын жеңілдетеді, бірақ бұл процестің тиімділігі сөздік қордың құрылымына тікелей байланысты. Мысалы, Qwen3-4B моделі жалпы бірнеше тіл мен мәтін түрлеріне арналған үлкен сөздік қорға ие. Бұл сөздік қор 151 669 таңбадан тұрады. Аталған модельге негізделген португал тіліндегі автоматты эссе бағалаушы жүйеде сол модельдің көпжақты және үлкен сөздік құрылысы нақты тапсырмаға сәйкес келмейді. Осыған байланысты бағалаушының есебінен пайдаланылатын сөздік құрамын азайту және қайта құру мәселесі туындайды.
Нақты модельде сөздік қордың үлкен көлемі екі негізгі шығын тудырады: біріншісі – мәтіннің көп бөлініп, қайталанып жатқан жиі қолданылатын сөздер мен өрнектер бірнеше токенге айналуы, яғни фрагментация; екіншісі – сөздік қорда тапсырмаға қажет емес көптеген таңбалардың бар болуы, нәтижесінде әрбір шығатын таңба үшін үлкен көлемдегі сөздіктің қайтарып шығару есебі жүргізіледі. Бұның өзі өңдеу уақытын арттырады және есептеу ресурстарын көп қажет етеді.
Оқыту мен генерация кезеңіндегі шығындар
Модельдің жұмысын екі фазаға бөлуге болады: алдымен кіріс мәтінді өңдейтін «prefill» кезеңі және кейін жауапты бір токен бір токеннен шығаратын «decode» кезеңі. Бірнеше токеннен тұратын кіріс өңдеу салыстырмалы түрде арзанға түссе, шығарылатын токендер генерациясы күрделі әрі көп есептеу талап етеді. Әсіресе, decode кезеңінде модель жиі жадыға тәуелді болып, белгілі бір токенді шығарудың себебі ретінде жады жүктемесін арттырады. Әдетте, generate (шығару) кезеңінің құны read (кіру) кезеңінің құнынан 7-8 есе көп болуы мүмкін.
Сондықтан жалпы токен санын азайтумен қатар, жауаптағы токен санына ерекше назар аудару қажет. VocabX әдісі негізінен осы басты шығынды азайтуға ұмтылады. Сонымен қатар, сөздік құрамының ықшамдалуы – модельге қажетті параметрлер санының кішіреюін де білдіреді. Бұл шағын модельдер үшін аса маңызды, себебі олардың есептеу қуаты мен жады шектеулі. Сөздік қордың азаюы модельдің LM (language model) басында қолданылатын параметрлер матрицасын ықшамдайды.
Контекст және мысалдар
Португал тілінде эссе бағалаушы жүйе мысалында сөздік қордың үлкен көлемі негізгі кедергі болды. Әрбір жауап JSON форматындағы бірдей құрылыммен берілген, бұл құрылым сөздердің неғұрлым көп токенге бөлінуіне және модельдің осы токендердің барлығын санауына әкелді. Сонымен қатар, күрделі мәтіннің қайталанатын фрагменттері бірнеше токенге бөлініп, үздіксіз шығын тудырды.
Дәстүрлі сөздік құру әдістері жиілікке негізделген, яғни текстте көп кездесетін сөздер жаңа токендер ретінде топтастырылады. Алайда, жиі емес, бірақ жауапта көп қолданылатын сөздер құндылығы төмен бағаланып, өзекті салаларды толық қамти алмады. Бұл әдістер көбінесе тек бір ғана деңгейде жұмыс істейді – сөздердің бөлінуі немесе бірнеше сөздердің біріктірілуі. Ал ұзын қайталанатын қатарлар, мысалы JSON құрылымындағы өрнектер, тиісті емессіз қала берді.
Практикалық маңызы
VocabX әдісі сөздік құруды қайта ойластырды. Ол бірінші кезекте шығынды ғана санап, үнемді токендерді анықтау әдісін енгізді. Токеннің тиімділігін оның қай мәтін аймағында (қолданушының хабарламасы, жүйе сұрауы, модель жауабы) пайда болуына қарай есептеді. Осындай тәсілмен генерация кезеңіндегі маңызды шығындарға басымдық берілді, себебі жауапты шығарудағы токендердің бағасы кірістік токендерге қарағанда 7 есе жоғары болды.
Сонымен қатар VocabX екі деңгейде жұмыс істеді: біріншісі – сөздерді кіші бөліктерге бөлуді жаңаша ұйымдастыру, екіншісі – қайталанатын сөз тіркестері мен тұтас қатарларды макро-токендерге біріктіру. Макро-токендер арнайы жиі қайталанатын мәтіндер үшін тиімді, олар автономды токендерді азайтып, өткізілетін деректер көлемін төмендетеді.
Осындай кешенді амалдар нәтижесінде нақты ортада жұмыстағы модельдің есептеу шығындары 77 % төмендеді. Сөздік қорының көлемі 152 мыңнан 65 мыңға дейін қысқарды, бұл ресурстарды үнемдеумен қатар есептеу жылдамдығын арттырды.
Қорытынды
SLM модельдерінің сөздік қорын нақты бір салаға көркемдеу арқылы есептеу ресурстарын айтарлықтай үнемдеуге болады. Жиілікке емес, шығынға негізделген сөздік құру стратегиясы модельдің генерациялау кезеңіндегі ең қымбат шығындарын төмендетеді. Бірнеше деңгейлі символ және сөз тіркестерін оптимизациялау тәсілі кез келген тапсырманың өнімділігін арттырады және қызмет көрсетудегі шығындарды қысқартады. Бұл әдістемелер нақты өндірістік жүйелерде кеңінен қолданылуда және алдағы уақытта модель тиімділігін арттыруға әсерін тигізбек.
TAGS: тілдік модельдер, VocabX, токенизация, жасанды интеллект, есептеу шығындары, тілдік модельді мамандандыру, үлкен модельдер
Дереккөз: Hugging Face Blog