Мамандырылған көпмодальды модельдерді LFM3 көмегімен құру
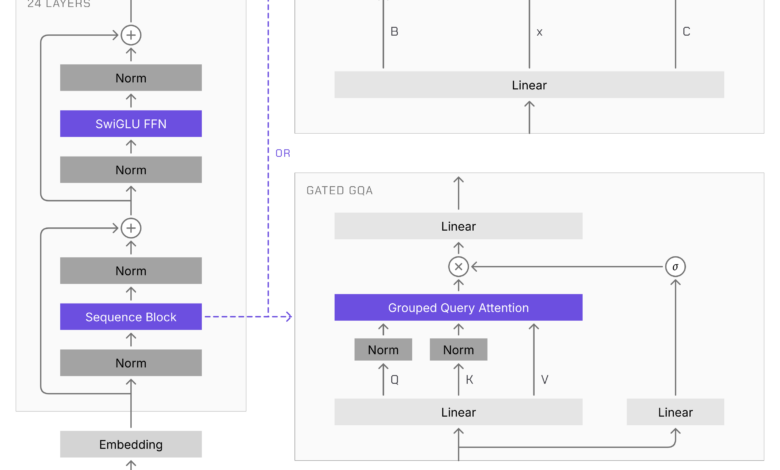
Жасанды интеллект саласында көпмодальды модельдер – мәтін, кескін, аудио, бейне сияқты әртүрлі дерек көздерін бір жүйеге біріктіретін күрделі құрылымдар. LFM3 – Liquid Foundation Models үлгісінің жаңа буыны, осы салада маңызды серпіліс жасауға бағытталған. Бұл модельдердің маңыздылығы – әртүрлі ақпарат түрлерін бір арнада тиімді өңдеу және арнайы тапсырмаларға бейімделу қабілетінде.
LFM3-тің басты ерекшеліктері мен түсіндірмесі
LFM3 – алгоритмдік және архитектуралық жағынан оңтайландырылған, негізінде 2 миллиард параметрі бар бірнеше модельден тұратын кешен. Оның негізгі жаңалығы – бір арналы, бірақ көпқырлы негізін құру арқылы мәтін, көру, аудио, бұйрық қабылдау және шешім қабылдауға арналған модельдерді бір платформаға біріктіргені.
LFM2 үлгісінің жетістігін негізге ала отырып, LFM3 үш түрлі әдісті бірге қолданады: қысқа конволюциялар, сырғанайтын терезелі көңіл бөлулер және жаһандық көңіл бөлулер. Бұл архитектура өнімділікті айтарлықтай арттырады, әсіресе ұзақ мәтін контекстінде жұмыс істегенде.
Үштік гибридті қабат құрылымы
Бұл құрылымда 24 қабат бар, оның ішінде 13-і – қысқа конволюциялық, 5-і – сырғанайтын терезелі көңіл бөлулер (256 таңбалық тереземен), 6-сы – жаһандық көңіл бөлулер. Бұл алдыңғы аппараттық талаптарға қарамастан жоғары сапалы нәтиже береді.
Жақсарған көңіл бөлу және қалыпқа келтіру әдістері
Арнайы жұмыс принципі бойынша әрбір көңіл бөлу басы оның үлесін реттей алады, ал модель активизацияларын тиімді қалыпқа келтіру арқылы дыбыстық және мәтіндік ақпаратты жақсы өңдейді.
Контекст және мысалдар
LFM3 базасы 22 триллион таңбадан тұратын мәтіндік және арнайы агенттік деректермен алдын ала оқытылды. Бұл модельдің контекстік терезесін 256 мың таңбаға дейін ұлғайту мүмкіндігі, оның ұзақ мәтіндердегі тиімділігін арттырады.
Модельдердің түрлері әртүрлі ақпарат түрлерімен жұмыс істеуге арналды:
- LFM3-1.7B – мәтіндік тапсырмаларға;
- LFM3-VL-2B – мәтін, кескін және бейнеге;
- LFM3-Audio-2B – мәтін мен аудиоға;
- LFM3-Omni-2B – мәтін, кескін, бейне және аудионы біріктіреді;
- d1-2B және d1-omni-2B – жауаптарды калибрлеуге арналған.
Осы модельдерде жаңартылған көру және аудио энкодерлері бар. Мысалы, көру моделі 164 миллион параметрлі энкодерді қолданады, ол бұрынғыларға қарағанда есептеу көлемін үш есе азайтады, бірақ дәлдікте жоғалтпайды. Олар бейне деректерін өңдегенде әр екі кадрды бір топқа біріктіреді, бұл жылдамдықты арттырады.
Практикалық маңызы
LFM3 моделі шағын көлемде, орташа қуатты құрылғыларда (мысалы, 1 ГБ жад жақта 4-биттық дәлдікпен) іске қосылуға бейімделген. Бұл мобильді құрылғыларда агенттік қосымшаларды, құралды шақыруларды және нақты уақыттағы шешім қабылдауды қолдайтын құралдарды дамытуға мүмкіндік береді.
Мысал ретінде, LFM3-1.7B моделі агенттік тапсырмаларда және құрылғылардағы ұзақ мәтінді өңдеу мәселелерінде үлкен жетістіктерге қол жеткізді. Бұл модель өзінен бұрынғы LFM2.5-2.6B үлгісін 35% аз параметр санына қарамастан басып озды және белгілі бизнес пен браузерлік тапсырмаларда кешігу уақытын төмендетті.
Көру моделі LFM3-VL-2B видео деректерін өңдеуде жаңа деңгейге көтерді. Ол робототехника мен бейнелерді түсінуді қажет ететін басқа да нақты қолданбалар негізі болуы мүмкін, себебі объектілерді анықтап, олардың орналасуын жүйелі түрде түсінеді.
Қорытынды
LFM3 циклдік желілері мен көпмодальды мүмкіндіктері арқылы заманауи жасанды интеллект талаптарына сай келетін, жеңіл әрі қуатты негіз құрады. Оның негізгі артықшылығы – адаптация жылдамдығы мен әртүрлі дерек көздерімен жұмыс істей алатын икемділігі. Бұл салада қолданылу аясы кеңейіп, жасанды интеллект бағдарламаларын жасауда жаңа мүмкіндіктер ашады.
TAGS: көпмодальды модельдер, жасанды интеллект, LFM3, нейрондық желілер, көру және аудио өңдеу, агенттік жүйелер, адаптивті модельдер
Дереккөз: Hugging Face Blog