Scaling Indic алдын ала оқыту: 2,8 триллион таңба және ашық дерек генерациялау жүйесі
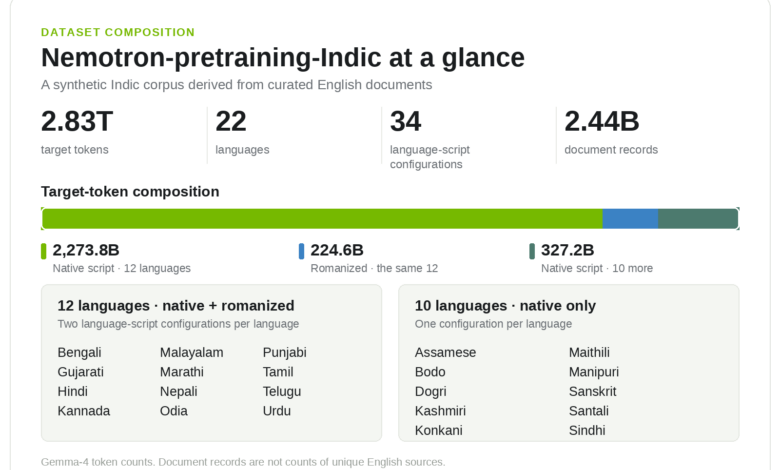
Жасанды интеллект саласында үлкейту және көбірек сапалы мәліметтер жинау – тілдік модельдердің дамуына негіз болып табылады. Индиялық тілдердің технологиялық дамуы үшін көп көлемді мәліметтер базасын құру – маңызды мәселе саналады. Осы мақалада 22 индиялық тілдерге арналған 2,8 триллион таңбалық алдын ала оқыту корпусы және оны құруға арналған ашық, GPU-ге жылдам бейімделген дерек генерациялау жүйесі туралы айтылады.
Кіріспе
Тілдік модельдер адамның табиғи тілін түсіну және өңдеуде саналы роль атқарады. Алайда индиялық тілдерде сапалы мәтіндік мәліметтердің жетіспеушілігі олардың дамуын қиындатады. AI4Bharat және NVIDIA, IIT Madras-пен серіктестікте, 22 индиялық тілді қамтитын мол көлемді мәліметтер базасын жасап, модель құрушыларға аса қажетті ресурсты ұсынды. Бұл зерттеу индиялық тілдерде жасанды интеллект жүйелерінің сапасын арттыруға бағытталған.
Негізгі түсіндірме
Корпус құрамында 2 601 миллиардтық туған тілде жазылған таңба мен 224,6 миллиардтық романизацияланған (латын қарпіндегі) таңба бар. Бұл деректер 22 заңнамалық индиялық тілге қатысты. Туған тілдегісі – мәтіндер сәйкес тілдің ұлттық жазуында, романизацияланғаны – сол тіл мәтінінің латын әліпбиіндегі түрі. Мысалы, бенгали, гуджарати, хинди секілді 12 тіл екі түрлі сценарийде ұсынылған. Басқа 10 тіл тек ұлттық жазуда қамтылған.
Мәліметтер ағылшын тіліндегі бастапқы құжаттардан аударылып, кейін сапа тексерісінен өткізіледі. Аударма сапасын бағалау үшін ашық сапа метрикалары (Multidimensional Quality Metrics) пайдаланылады, онда мағына, ағындылық, терминология және форматтық аспектілер қаралады. Қалыпты деңгейден төмен нәтижелер артқа қайтарып шығып, өңдеуден өтеді. Әрбір аударма деректің түпнұсқа дереккөзіне сілтеме жасай алады, бұл ашық дерек көзі ретінде сенімділік пен қайталанушылыққа мүмкіндік береді.
12 тілге арналған жұмыс процесі
Бұл тілдердің мәтіндік материалдары толық құжат ретінде, яғни абзацтар, кестелер, теңдеулермен бірге аударылады. Бұл кезеңде Gemma-4-31B-it моделі аудармаларды жасайды және бағалайды. Сонымен қатар, код, URL, теңдеулер сияқты техникалық ақпарат сақталатын ерекше индикациялар қолданылады. Романизацияланған мәтіндер де туған тілдегі аудармалардан құралған және олардың біркелкілігі сақталады.
10 тілге арналған жұмыс процестері
Қалған 10 тіл үшін басқа жұмыс алгоритмдері қолданылады. Мұнда Bodhan AI-дің Indic Translate деп аталатын, 22 индиялық тілге арналған құжат деңгейіндегі аударма моделі пайдаланылады. Gemma-4-31B-it моделі сол аудармаларды сапа жағынан тексереді. Бұл тәсіл үлкен көлемді мәтінді аударуда және әр түрлі жазу ерекшеліктерін сақтауда тиімді ерекшеленеді.
Контекст және мысалдар
Модельдердің дамуы үшін тек мәтіннің көлемі емес, сапасы да маңызды. Ұсынылған корпус техникалық мәтіндер (математика, код, сұрақ-жауап материалдары) және әр түрлі тақырыптарды қамтитын біздің заманымыздағы ақпараттарды қамтиды. Әрбір мәтін тармақтары бастапқы ақпаратпен салыстырылып, оның мағынасы мен құралымдары сақталуы қамтамасыз етілді.
Мысалы, математикалық теңдеулердің дәл аудармасы мен код үлгілерінің сақталуы модельді технологиялық түсініктерді өңдеуде күшті етеді. Бұл индиялық тілдердегі теориялық және қолданбалы білімдерді қолдауда маңызға ие.
Практикалық маңызы
Жаңа ашылған ресурс модель жасаушыларға индиялық тілдер бойынша сапалы алдын ала оқыту деректерін қамтамасыз етеді. Ашық және қайталанатын дерек генерациялау процесі әрбір зерттеушіге өзінің бастапқы материалын қолданып, модельдерін жетілдіруге мүмкіндік береді. Бұл индиялық тілдердегі жасанды интеллект жүйелерінің жетілуіне серпін береді.
Жобаның ашық сипаты білім алмасуға, жаңа әдістердің енгізілуіне және үлкен көлемді тілдік модельдерді жасап шығару жолындағы бөгеттерді азайтуға ықпал етеді. Бұл индиялық тілдерді ақпараттық жүйелер мен білім беру платформаларында кеңінен қолдану мүмкіндігін арттырады.
Қорытынды
2,8 триллион таңбадан тұратын қазақтан тыс индиялық тілдік корпус пен ашық дерек генерациялау жүйесі үлкен жаңалық саналады. Мұндай кең көлемді және құрылымды мәліметтер базасы индиялық тілдердегі модельдердің сапасын арттырып, жасанды интеллекттің көптілділік деңгейін көтереді. Ашықтық пен жоғары сапа – болашақ зерттеулер мен технологиялық жетістіктерге жол ашады.
TAGS: жасанды интеллект, индиялық тілдер, алдын ала оқыту, табиғи тілдерді өңдеу, тілдік модельдер, ашық дерек, мәліметтер базасы
Дереккөз: Hugging Face Blog