Жасанды интеллекттегі көру және тіл модельдерін жеделдету: LFM2.5-VL-DSpark
Кіріспе
Көру және тіл модельдері (VLM) жасанды интеллект саласында бейне мен мәтін арасындағы өзара байланысты түсіну және өңдеуді жетілдіруге бағытталған маңызды технологиялар қатарына жатады. Мұндай модельдер үлкен есептеу қуатын талап етеді, сондықтан олардың жылдамдығы мен тиімділігін арттыру – зерттеушілер мен әзірлеушілер үшін өзекті мәселе. LFM2.5-VL-DSpark моделі – осы бағытта жасалған жаңа эксперименттік шешім, ол визуалды және мәтіндік деректерді өңдейтін модельдердің жылдам жұмыс істеуіне мүмкіндік береді.
Негізгі түсіндірме
LFM2.5-VL-DSpark – LFM2.5-VL-3B визуалды тіл моделі үшін әзірленген жылдамдату технологиясы. Бұл модель «спекулятивті декодтау» әдісін қолданып, жад көлемін сәл ғана арттырып, өңдеу жылдамдығын едәуір жақсартады. Спекулятивті декодтау процессі мәтін өңдеудегі дәл сол тәсілді пайдаланады, мұнда модель жасырын күйін белгілеген қабаттардан алады да, бірнеше болжамды таңба тобын бірден жобалайды. Көзбен қабылдаған кескіннің фрагменттері мен мәтін белгілері ортақ көрініске айналдырылады, осылайша модель қандай түрдегі ақпарат қабылдаса да бірдей өлшемдегі векторлармен жұмыс істейді.
Модельдің техникасы және оқытуы
LFM2.5-VL-DSpark оқыту процесінде визуалды және мәтіндік деректердің аралас жиынтығы қолданылады. Модель төрт қабатты, тек назар аудару элементтері бар қарапайым қысқаша жобалаушы болып келеді, оның «блок» көлемі 9 таңбадан тұрады. Оқыту 10 кезең бойынша жүргізіліп, әр кезең соңында жылдамдық артқаны байқалғанымен, көп оқыту тиімділікке үлкен әсер бермейді. Пайдаланушы үшін блок өлшемін 8 немесе 9 таңбадан таңдау ұсынылады. Бұл қосымша модуль модельдің жалпы параметр санын шамамен 8,9 пайызға арттырады, яғни 280 миллион параметр қосылады.
Контекст және мысалдар
DSpark моделі llama.cpp, MLX-VLM, SGLang платформаларында бірден қолданылады. Іскери техника ретінде оның жұмысын әртүрлі құрылғыларда сынап көргенде мынадай нәтиже көзге түседі:
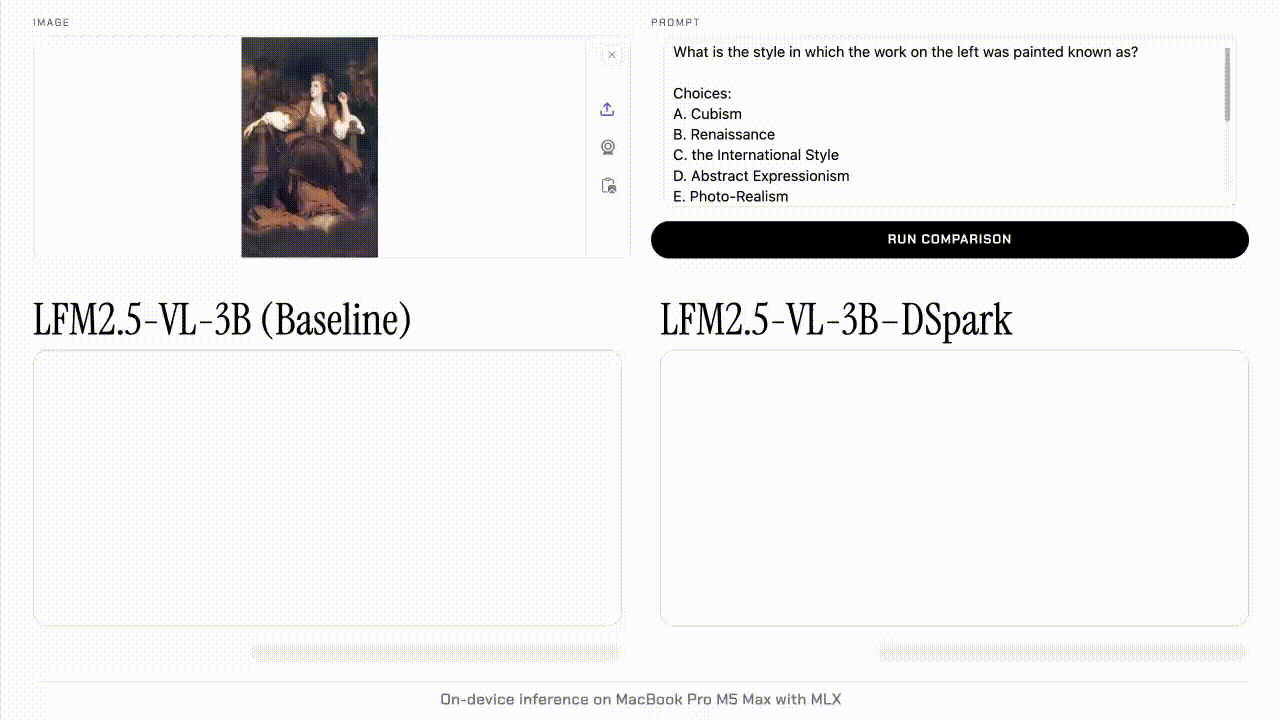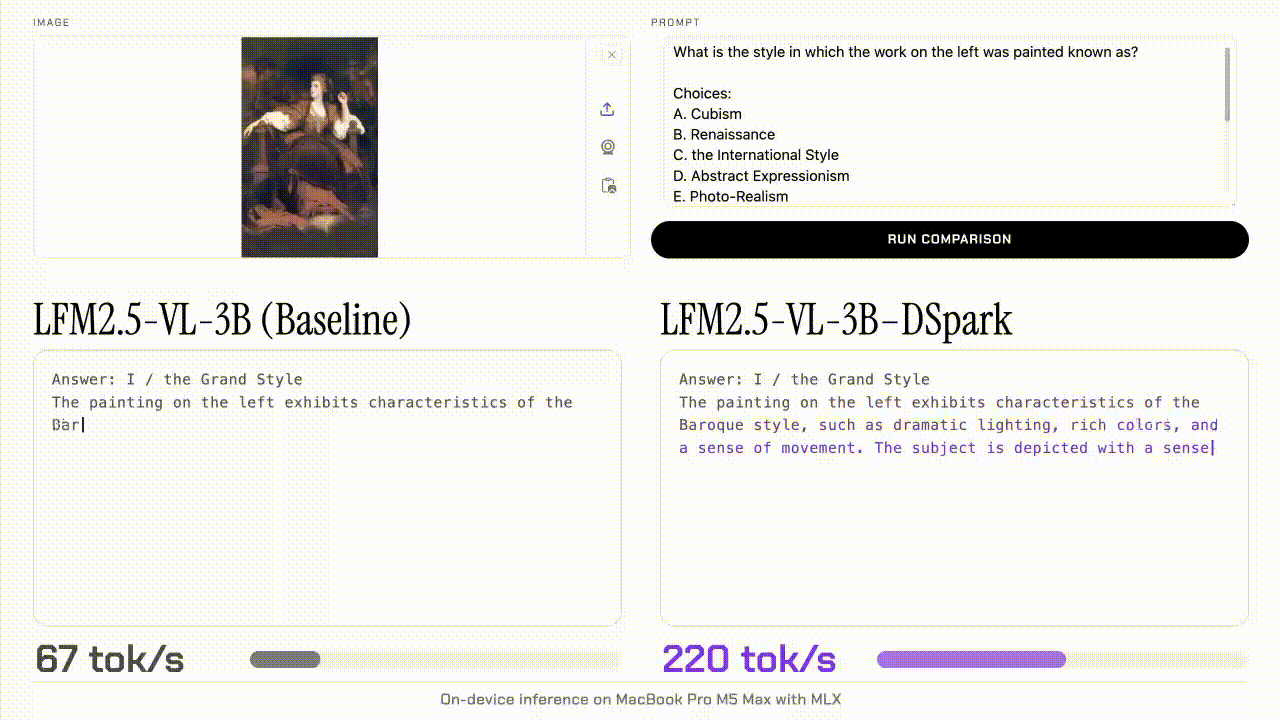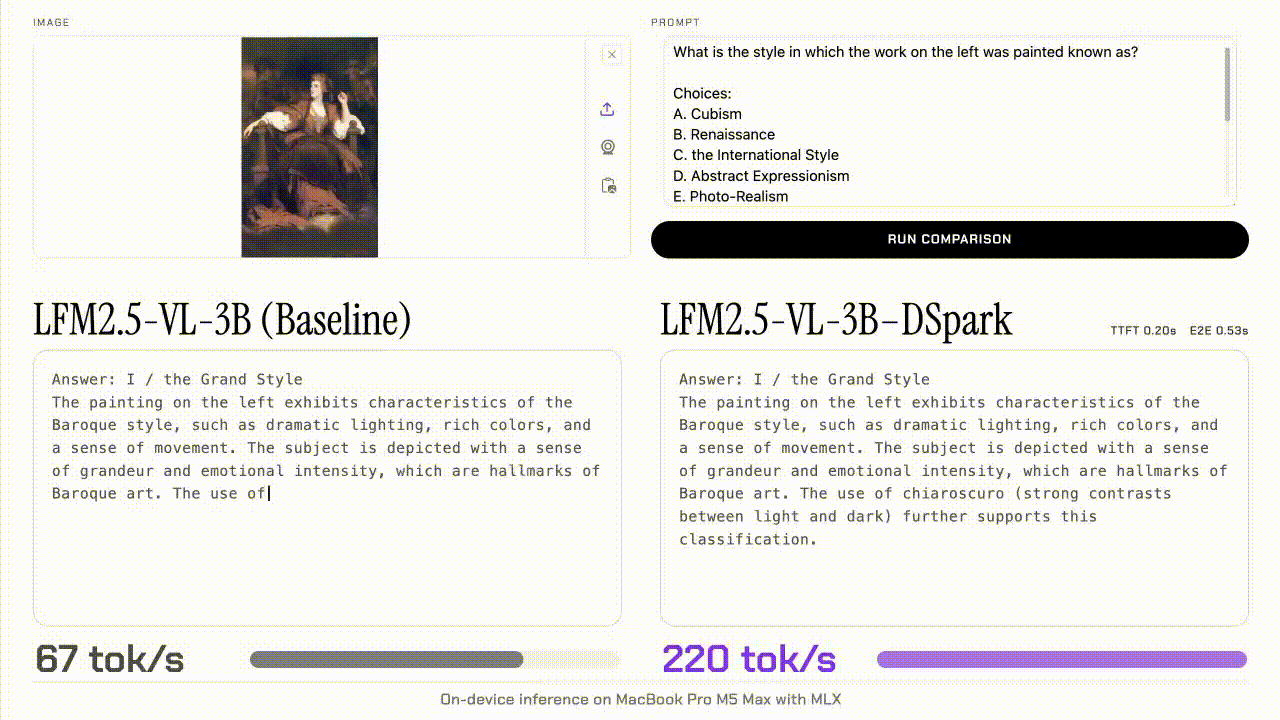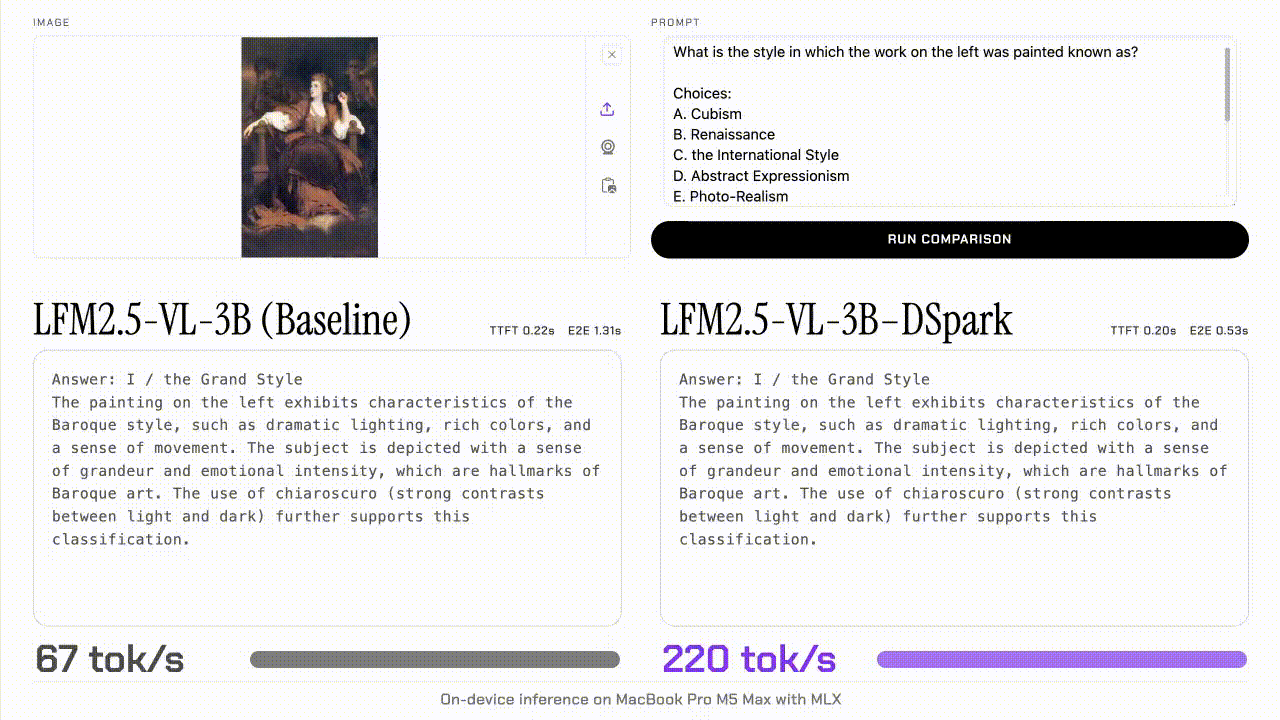
- MLX-VLM-ді M5 Max процессорында пайдалану кезінде декодтау жылдамдығы 2,3-3,13 есе, жалпы пайдалану уақыты 1,56-2,62 есе жақсарады.
- llama.cpp платформасында M3 Ultra процессорында декодтау 1,57-2,14 есе, ал соңғы нәтиже 1,3-1,77 есе жылдамдады.
- H100 GPU-да декодтау 2,04-2,66 есе тезірек іске асырылып, жалпы уақыт 1,64-2,27 есе қысқарды.
Бұл көрсеткіштер мультитапсырмалық визуалдық міндеттерде, соның ішінде суретке сұрақ-жауап, мәтін арқылы сурет сипаттау және күрделі ақыл-ой операциялары барысында байқалды.
Шектеулері
Көру және тіл модельдері бейнені алдын ала өңдеу кезеңінен өтеді, бұл кезең өңдеудің жалпы уақытының көп бөлігін алады. Спекулятивті декодтау тек декодтау процессін тездетеді, кескінді кодтау мен бастапқы дайындық уақытына әсер етпейді. Осы себепті, бейнелік тапсырмаларда толық жылдамдық үдеуі шектеулі болады. Бұл жағдай Амдал заңы бойынша түсіндіріледі, яғни жүйенің жылдамдығын арттыру оның баяу бөліктеріне тәуелді.
Практикалық маңызы
LFM2.5-VL-DSpark моделінің қолданылуы әртүрлі құрылғыларда визуалды-мәтіндік тапсырмаларды жедел орындауға мүмкіндік береді. Бұл әсіресе шеткі құрылғылар (edge devices), мысалы, смартфондар мен жеңіл компьютерлер үшін маңызды, себебі оларда есептеу қуаты шектеулі. Модельді іске қосу үшін арнайы платформаларда бірқатар техникалық талаптар орындалуы қажет, соның ішінде LFM2.5 қолдауы бар SGLang, llama.cpp немесе MLX-VLM құрылымдары қолданылады. Лицензия мен жеңіл қолжетімділік арқасында бұл технологияны әркім жүктеп алып, өз жобаларында пайдалана алады.
Қорытынды
LFM2.5-VL-DSpark технологиясы визуалды және тілдік модельдердің өнімділігін арттыруға бағытталған маңызды жаңалық болып табылады. Жад көлеміндегі азырақ өсіммен және шектеулі техникалық өзгерістер арқылы модельдің өңдеу жылдамдығын үш есе жақсартуға мүмкіндік ашады. Бұл тәсіл жасанды интеллект жүйелерін тиімді әрі қолжетімді етуге ықпал етеді.
Дереккөз: Hugging Face Blog